Как запустить LLM на своём сервере: Ollama, vLLM и что выбрать
Языковую модель можно вызывать по чужому API, а можно поднять у себя. Второй путь выбирают по трём причинам: данные не уходят наружу, стоимость перестаёт зависеть от числа запросов, и версия модели не меняется без вашего ведома. Взамен появляется сервер, за которым надо следить.
Разберём, чем отличаются инструменты запуска, сколько нужно памяти и диска, как отдать модель приложению и не открыть её всему интернету, и в какой момент своя модель становится дешевле облачной.
Когда своё оправдано
Честный ответ: не всегда. Облачный API выигрывает, пока запросов немного и данные не чувствительны, потому что вы не платите за простой.
Своя модель начинает выигрывать в четырёх случаях:
- Данные не должны покидать контур. Персональные данные, документы, переписка. Здесь вопрос вообще не в деньгах.
- Поток запросов постоянный. Карта, занятая круглосуточно, дешевле поштучной оплаты за токены на достаточном объёме.
- Нужна фиксированная версия. Модель у вас не обновится посреди недели и не изменит поведение.
- Модель дообучена под вас. Свой адаптер после дообучения в чужом облаке просто не запустить.
Если ничего из этого не про вас, начните с API и вернитесь к своему серверу, когда упрётесь.
Чем запускать
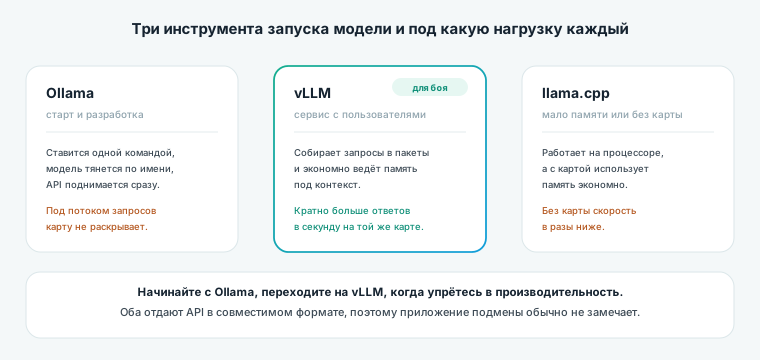
Инструментов много, на практике выбор сводится к трём.
Ollama. Самый простой старт: ставится одной командой, модель скачивается по имени, сразу поднимается локальный API. Идеален для разработки, прототипов и личного использования. Слабое место - параллельные запросы: под потоком он не раскрывает карту полностью.
vLLM. Инструмент для боевой нагрузки. Умеет объединять запросы в пакеты и эффективно управлять памятью под контекст, за счёт чего выдаёт кратно больше запросов в секунду на той же карте. Сложнее в настройке, но именно его берут, когда модель обслуживает приложение с пользователями.
llama.cpp. Работает и без видеокарты, а с ней использует память экономно. Выбор, когда карты нет вовсе или когда модель надо втиснуть в скромный объём памяти.
Практическое правило: начинайте с Ollama, переходите на vLLM, когда упрётесь в производительность. Переписывать при этом почти нечего: оба отдают API в совместимом формате, и приложение обычно не замечает подмены.
Что нужно от сервера
Видеопамять определяет, какая модель вообще запустится. Считается по числу параметров и точности, подробный расчёт с таблицей - в статье сколько видеопамяти нужно для нейросети. Коротко: на 48 ГБ комфортно живёт модель на 7-13 миллиардов параметров в хорошей точности или существенно крупнее в квантованном виде.
Оперативная память нужна для загрузки: веса проходят через неё по пути в карту. Закладывайте не меньше объёма видеопамяти.
Диск - самый недооценённый пункт. Веса моделей весят десятки гигабайт, а держат обычно несколько штук для сравнения. Сотня гигабайт под модели расходится быстро, и читаются они при каждом запуске, поэтому NVMe заметно сокращает время старта.
Root-доступ. Версии CUDA и библиотек меняются часто, и ставить окружение придётся своё, см. что такое root-доступ.
Как отдать модель приложению
Оба инструмента поднимают HTTP-интерфейс, совместимый по формату с распространённым облачным API. Приложение обращается к нему как к обычному сервису, меняется только адрес.
Дальше действуют обычные правила эксплуатации:
- Модель слушает локальный адрес, наружу её выставляет веб-сервер, см. как выложить приложение на сервер.
- Процесс работает под службой, иначе он умрёт вместе с сессией.
- Порт модели не открывают в интернет. Это отдельный пункт, и он важнее, чем кажется.
Открытый наружу интерфейс модели - это ваша карта, работающая на чужие задачи. Ни авторизации, ни лимитов там по умолчанию нет: кто нашёл адрес, тот и пользуется, а платите за электричество и аренду вы. Сканеры находят такие порты так же быстро, как открытые базы. Доступ ограничивают правилом файрвола или закрывают авторизацией на веб-сервере, см. порты на сервере.
Что влияет на скорость
Три вещи, помимо самой карты.
Квантизация. Уменьшает модель и ускоряет ответ, немного теряя в качестве. Часто это лучший способ уместить более крупную модель и получить приемлемую скорость.
Длина контекста. Память под контекст расходуется на каждый активный запрос. Огромное окно, выставленное про запас, съедает память, которой не хватит на параллельные обращения.
Пакетная обработка. Главное преимущество vLLM: несколько запросов обрабатываются вместе, и суммарная пропускная способность растёт в разы без замедления отдельного ответа.
Отсюда практический вывод: для одного пользователя важна скорость одного ответа, для сервиса с посетителями - число ответов в секунду. Это разные настройки и часто разные инструменты.
Сколько это стоит
Считать нужно от загрузки, а не от цены карты. Модель, отвечающая пару часов в день, дешевле работает по чужому API. Модель под постоянным потоком запросов дешевле на своей карте.
Точка перехода индивидуальна, но проверяется быстро: возьмите карту на несколько часов, замерьте реальную пропускную способность на своих запросах и сравните со счётом за API при том же объёме. Почасовая аренда для такой проверки и нужна, а методика расчёта окупаемости разобрана в статье купить видеокарту или арендовать GPU.
Частые ошибки
Берут самую большую модель, какая влезла. Под конкретную задачу модель поменьше часто отвечает не хуже, а стоит в разы дешевле в эксплуатации.
Открывают порт модели наружу. Чужие запросы на вашей карте и ваш счёт за них.
Тестируют производительность одним запросом. Под потоком картина меняется полностью, и выбор инструмента вместе с ней.
Ставят максимальный контекст на всякий случай. Память уходит на пустой запас, а параллельные запросы перестают помещаться.
Экономят на диске. Несколько моделей быстро занимают сотни гигабайт, и место кончается посреди эксперимента.
Считают экономику от цены карты, а не от загрузки. Простаивающая карта дороже любого API.
Частые вопросы
Зачем запускать LLM на своём сервере? Чтобы данные не уходили наружу, стоимость не зависела от числа запросов, версия модели не менялась без вашего ведома и можно было запускать собственные дообученные варианты.
Что выбрать: Ollama или vLLM? Ollama проще и подходит для разработки и личного использования. vLLM даёт кратно большую пропускную способность под потоком запросов и берётся для боевой нагрузки.
Какая карта нужна для запуска модели? Определяет видеопамять. На 48 ГБ комфортно работают модели на 7-13 миллиардов параметров в хорошей точности и заметно более крупные в квантованном виде.
Сколько места занимают модели? Десятки гигабайт каждая, а держат обычно несколько. Под модели закладывают сотни гигабайт быстрого диска.
Можно ли запустить модель без видеокарты? Да, через llama.cpp на процессоре, но скорость будет в разы ниже. Для одиночных запросов это рабочий вариант, для сервиса - нет.
Как безопасно отдать модель приложению? Держать её на локальном адресе, наружу выставлять через веб-сервер с авторизацией, порт модели в интернет не открывать.
Дешевле ли своя модель, чем облачный API? Только при достаточной загрузке. Карта, занятая несколько часов в день, проигрывает поштучной оплате. Проверяется замером на почасовой аренде.
Нужна карта под свою модель? GPU-серверы с RTX 4090 на 48 ГБ - почасовая оплата от 149 руб, конфигурации под инференс и обучение. Полный root-доступ: свой стек CUDA, PyTorch и vLLM без ограничений.